 tameshita
xerjとは?使い方・Claude Codeとの連携・日本語の検索を実際に使って調べてみた動いた
この日に実際に動かした結果です。内容の誤りに気づかれた場合はお問い合わせください。確認のうえ訂正します。
使う前に分かること
| 必要なもの | Claude Code、Git |
|---|---|
| 動かした環境 | Apple Silicon の Mac(macOS 26.5.1)、Claude Code 2.1.282。 |
| 日本語 | 日本語で使うときの注意あり(下に書いた) |
| 確認日 | 2026-09-27(この日に実際に動かした) |
Claude Code に「この中から〇〇を探して」と頼むと、ファイルを1つずつ開いて読みながら探します。フォルダが大きいと、その読む量がそのままトークンになります。XERJ は、フォルダの中身をあらかじめ検索できる状態にしておき、探し物を頼まれたら該当する箇所だけを渡す検索ツールです。
今回は、大量のファイルの中からの検索を試すため、日本語で書かれた JavaScript の入門書 js-primer(約600ファイル)を手元に取ってきて検索できる状態にし、実際にClaude Code にファイルの検索をしてもらいました。最後に、前に作ったアプリを取り込んで、今のアプリに機能を移す使い方も試しています。
Windows 用の入れ方は別にあり、今回は試していません。題材は自分のフォルダに置き換えて構いません。
参考にしたいオープンソースのプロジェクトを取ってきて検索する使い方、エージェントの覚え書きを貯める使い方、ブラウザで開く管理画面、意味の近さで探すための追加のモデルは、今回は試していません。
1行で入れて、検索のサーバーを立てる
入れるのはターミナルでこの1行です。Mac か Linux なら、パソコンに合ったファイルを取ってきて、中身が壊れていないかを確かめてから入れてくれます。
curl -fsSL https://xerj.org/get | sh
==> installing xerj v1.0.0-rc.77 for aarch64-apple-darwin
 ok  sha256 verified
xerj v1.0.0-rc.77 is ready.
次に、検索を受け付けるサーバーを立てます。検索用のデータを入れる data フォルダを作る場所で打ちます。このターミナルは開いたままにして、以降のコマンドは別のターミナルで打ちます。
xerj --insecure --data-dir ./data
--insecure は、パスワード代わりの鍵と通信の暗号化を切る指定です。その代わり、同じパソコンの中からしかつながらない設定で立ち上がります。起動すると、こう出ます。
 Native REST  127.0.0.1:8080 [plain]
 ES-compat    127.0.0.1:9200 [plain]
 │ ✓  Bind:   127.0.0.1 — loopback only; nothing off this host can reach the
 │ ⚠  Auth:   DISABLED (--insecure) — anyone on the network can write
4行目の警告は「鍵が無いので、つながれる人なら誰でも書き込める」という意味です。3行目のとおり、つながれるのはこのパソコンの中からだけです。ポートは 9200 と 8080 の2つあり、8080 のほうは最後の見出しで使います。一番上には、ブラウザで管理画面を使うための使い捨てのリンクも出ます。今回は開いていません。
Claude Code から使えるようにする
検索したいフォルダ(今回は js-primer)に入って、xerj init を打ちます。
cd js-primer
xerj init
xerj init — wiring XERJ into this project:
  auth     no --auth given and no local admin key found; if the node at {url} runs with auth on, add "XERJ_AUTH": "ApiKey <key>" to the .mcp.json env — the key is the node's <data-dir>/admin.key
done. Restart the agent session to pick up the tools, then
このフォルダの中に3つのファイルが書かれます。パソコン全体の Claude Code の設定は変わりません。
.mcp.json:Claude Code から XERJ の検索をツールとして呼べるようにする設定。js-primer には元から別のツールの設定が入っていましたが、それは残したまま XERJ を足していました(元のファイルは.mcp.json.bakとして残ります).claude/skills/xerj/SKILL.md:「探し物は grep ではなくxerj searchで」と教える10行ほどのスキルAGENTS.md:同じ内容の短い案内。Claude Code が自分から読むのは上の2つです
auth の行は鍵を付けて立てた時の話なので、--insecure で立てた今回は関係ありません。その行の {url} は、本来サーバーの場所が入るはずの所がそのまま出ている表示の間違いですが、動きには関係ありません。画面の指示どおり、Claude Code を開いていたら開き直します。
フォルダを検索できる状態にする
js-primer の1つ上のフォルダに戻り、フォルダ名を渡します。
xerj autoindex js-primer
途中経過が流れたあと、最後にこう出ます。
done in 21.1s — 8 datasets, 2916 records live, 68 duplicate aliases, 3 junk records, 119 junk/skipped files (138.0 docs/sec)
indexed: 2916 documents live; this run submitted 2507 source records from 409 files
  resources/js-primer.sketch — unextracted zip archive: autoindex does not open archives — extract it first (unzip <file>), then run autoindex on the extracted folder
30秒ほどで、中身を読んだ409個のファイルが検索できる状態になりました。119個は検索に向かないものとして飛ばした、と出ています。圧縮されたファイル(今回はデザインのファイル1つ)は開かないので、中も探したいなら先に展開してください、と教えてくれます。
うまくいったのに、終了コードは0ではなく3でした。手で打つ分には気にしなくて構いませんが、自動で動かす手順の中から呼ぶ時は「3でも成功」と扱う必要があります。
xerj-done ok=true exit=3 reason=completed-with-junk wall=28.8s files=409 records=2916 datasets=8 junk_files=119 code_files=246 code_files_indexed=246 code_files_junked=0
日本語で検索してみる
まず自分で検索します。サーバーが動いていれば、どのフォルダで打っても構いません。日本語の文で聞いてみました。
xerj search "非同期処理のエラーをキャッチする方法"
─── source/basic/async/OUTLINE.md  (score 36.06)
─── source/basic/async/README.md  (score 34.96)
─── source/basic/async/README.md  (score 34.78)
5 passage(s) from 'ax-*'. Cite ax_path:line for anything you rely on.
score は当たり具合で、大きいほど上に並びます。当たったのは非同期処理の章で、ファイルは合っています。ただ、本来ファイル名の下に出るはずの本文の抜粋が、5件とも空でした。英単語で聞くと、抜粋が出ます。
xerj search "Promise"
─── source/basic/async/README.md  (score 5.30)
    ### `Promise.race` {#promise-race}
    `Promise.all`静的メソッドは複数のPromiseがすべて完了するまで待つ処理でした。
日本語だけの言葉で4通り試したところ、「非同期処理のエラーをキャッチする方法」と「エラー処理」は5件とも抜粋が空で、「配列の分割代入」も表示した4件のうち3件が空でした。「分割代入」で出た抜粋は、分割代入ではなく代入演算子の説明の段落でした。
─── source/basic/operator/README.md  (score 18.15)
    ## 代入演算子(`=`) {#assignment-operator}
一方、次の見出しで Claude Code が「Promise catch メソッド エラー 受け取る」のように英単語と日本語を混ぜて検索した時は、日本語の本文がきちんと抜粋されて返ってきました。日本語の文書を探すなら、関数名などの英単語を混ぜて聞くのが確実です。
Claude Code に探し物を頼む
ここが本題です。xerj init したフォルダ(js-primer)で Claude Code を開き、次のように頼みました。比べるために、xerj init をしていない同じフォルダのコピーでも同じ文を頼んでいます。
この本の中で、Promiseで起きたエラーをcatchで受け取る方法を説明している箇所を探して、ファイル名と行番号、そこに載っているサンプルコードを1つ教えて。
XERJ のツールとスキルは Claude Code から見えていました。それでも、この頼み方では3回とも XERJ を使わず、いつもどおり grep で「catch」を探してファイルを開き、答えました。答え自体は正確です。
該当箇所は **`source/basic/async/README.md`** です。
- **`source/basic/async/README.md:395-417`**:「`Promise.prototype.then`と`Promise.prototype.catch`」節(見出しは331行目)の中にあります。`then(undefined, onRejected)` と同じことができる方法として `catch` メソッドを紹介し、失敗時の処理だけを登録するなら `catch` の利用を推奨しています(397・400行目)。
そこで、同じ文の頭に「xerjを使って、」と足して頼み直しました。今度は最初に XERJ で検索しています。
XERJで検索したところ、Promiseのエラーを `catch` で受け取る方法を説明している中心的な箇所はここでした。
- **`source/use-case/ajaxapp/promise/README.md`**: 実践編です。Promiseチェーンの中で発生したエラーを、`main` 関数の `catch` で一箇所にまとめて受け取る例が載っています。
XERJ を使った回は2回とも、grep だけの回では出てこなかった「実践編」の章も一緒に挙げてきました。ただ、XERJ の結果には行番号が付いていないので、行番号はどちらの回も grep とファイルを開いて取り直しています。 どの方法も明確な差はないですね。
使った量を並べるとこうなります。
| 頼み方 | XERJ を使ったか | やりとりの回数 | 書いた量(出力トークン) | 料金の目安 |
|---|---|---|---|---|
xerj init したフォルダ・そのまま(1回目) |
使わない | 3 | 969 | $0.16 |
xerj init したフォルダ・そのまま(2回目) |
使わない | 5 | 1,099 | $0.09 |
xerj init したフォルダ・そのまま(3回目) |
使わない | 4 | 1,118 | $0.16 |
xerj init していないフォルダ(1回目) |
― | 4 | 1,004 | $0.18 |
xerj init していないフォルダ(2回目) |
― | 4 | 1,010 | $0.08 |
xerj init したフォルダ・「xerjを使って、」を足した(1回目) |
使った | 7 | 1,650 | $0.12 |
xerj init したフォルダ・「xerjを使って、」を足した(2回目) |
使った | 4 | 1,333 | $0.17 |
「やりとりの回数」は、Claude Code が考えてはツールを使った回数です。「書いた量」は Claude Code が書いた文字の量をトークンで数えたものです。料金の目安は、claude -p で頼んだ時に結果と一緒に出る「同じ量を API の料金で払ったらいくらか」の見積もりで、読み込んだ量と書いた量をまとめた額です。定額のプランで使っているなら、この額を払うわけではありません。
同じ頼み方でも回ごとに倍ほどぶれていて、XERJ の有無による差はそのぶれに埋もれました。今回は「catch」という探しやすい言葉がある探し物で、grep だけの回も3〜5回のやりとりで見つけていました。
使った回数を数字で見る
xerj gain は、検索を何回受けて何回当たったかを数えて見せるコマンドです。そのまま打つと 9200 番を見に行って失敗しますが、エラー文が「起動時に Native REST と出たポートを使って」と教えてくれるので、8080 番を指定すれば出ます。
xerj gain --url http://localhost:8080
searches served 21 (43.0% found something; 12 zero-hit)
前に作ったアプリから機能を移す
前に作ったアプリにある機能を、今作っているアプリにも付けたい時にも使えます。前のアプリを XERJ に取り込んでおき、Claude Code にそこから探させます。
試しに、同じ js-primer に載っている Todo アプリの完成版を「前に作ったアプリ」(old-todoapp)に、「今から作るアプリ」(shopping:買い物リストアプリという想定)は、同じフォルダの途中の段階のアプリにしました。この2つを1つのフォルダに並べて置き、以降のコマンドはそのフォルダで打ちます。完成版にある機能を途中の段階のアプリに移してもらいます。
前のアプリに oldapp という名前を付けて取り込みます。取り込みは Git でコピーする仕組みなので、前のアプリは Git で1回はコミットしてあるフォルダにしておきます。まだ Git で管理していなければ、前のアプリのフォルダで git init をして、全部のファイルを1回コミットしておきます。
xerj corpus add oldapp ./old-todoapp
  [clone] old-todoapp
          licence=NONE-FOUND sha=e8b9a74813c5 files=10
          ^ NONE-FOUND: adapt the APPROACH, do not copy the code
ライセンスのファイルが無いため、「考え方だけ参考にして、コードは写さないで」という注意が付きました。自分で作ったコードでも、ライセンスのファイルを置いていなければ同じ注意が出ます。続けて、取り込んだものを検索できる状態にします。
xerj corpus index oldapp
corpus 'oldapp' searchable: 39 records
10ファイルの小さなアプリなので、9秒ほどで終わりました。取り込んだものから探すのは xerj code というコマンドです。
xerj code oldapp "checkbox completed delete button"
─── old-todoapp/src/view/TodoItemView.js  (score 10.29, NONE-FOUND)
    [method createElement @ line 11 — 854 of 1,582 chars]
    createElement(todoItem, { onUpdateTodo, onDeleteTodo }) {
移したい機能(チェックボックスと削除ボタン)を作っているファイルと行番号、その部分のコードが返ってきます。
次に、今のアプリの shopping フォルダで xerj init をします。ただ、xerj init が置くスキルには xerj code が書かれていないので、Claude Code が毎回自分から読む CLAUDE.md を shopping フォルダに作り、1行だけ書いておきます。メモ帳などのテキストエディタで次の1行を書き、CLAUDE.md という名前で保存します。
前に作ったアプリ(oldapp)のコードを参考にする時は、ファイルを開く前に `xerj code oldapp "探したいこと"` で探す。
shopping フォルダで Claude Code を開き、こう頼みました。XERJ のことは依頼文に書いていません。
前に作った Todo アプリ(../old-todoapp)にある「完了にするチェックボックス」と「削除ボタン」を、この買い物リストにも同じ作りで付けて。
2回頼んで、2回とも Claude Code は最初に xerj code oldapp "完了にするチェックボックス" と xerj code oldapp "削除ボタン" を日本語で打ち、前のアプリの該当箇所を探してから作業に入りました。終わると、こう返ってきます。
買い物リストに、旧 Todo アプリと同じ作りで「完了にするチェックボックス」と「削除ボタン」を付けました。
- `src/model/ShoppingListModel.js`:旧アプリの `updateTodo` と `deleteTodo` に当たる `updateItem` と `deleteItem` を追加しました。既存の `addItem` と名前をそろえています。
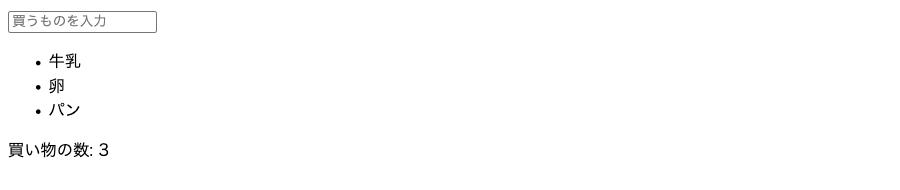
手元でページを配信し(ターミナルで python3 -m http.server を打って、ブラウザで index.html を開く)、牛乳・卵・パンを追加してみます。移す前の買い物リストは、並べて件数を出すだけでした。
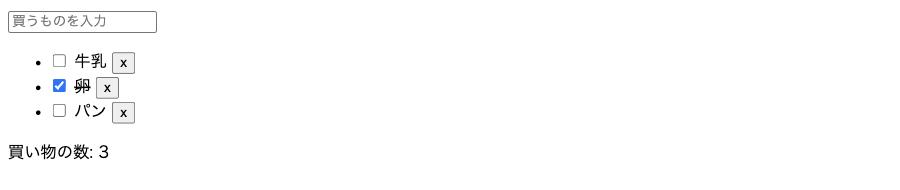
移した後は、それぞれにチェックボックスと「x」のボタンが付きます。卵にチェックを入れると取り消し線が付き、パンの「x」を押すと消えて「買い物の数: 2」になりました。
同じ依頼文を、xerj init していない買い物リストでも2回頼みました。こちらでも、同じ作りで動くものができています。
| 頼み方 | 前のアプリの見方 | やりとりの回数 | 料金の目安 |
|---|---|---|---|
| XERJ なし(1回目) | ファイルを13個開いた | 24 | $0.39 |
| XERJ なし(2回目) | ファイルを15個開いた | 26 | $0.41 |
| XERJ と CLAUDE.md の1行あり(1回目) | xerj code で探した後、中身を表示するコマンドで何個分かをまとめて表示した |
12 | $0.36 |
| XERJ と CLAUDE.md の1行あり(2回目) | xerj code で探した後、ファイルを11個開いた |
21 | $0.39 |
XERJ で探した後も、Claude Code は「同じ作りで」を守るために、前のアプリの中身を確かめていました。前のアプリが10ファイルほどと小さく、全部読んでも安く済むため、使った量に大きな差は出ていません。
まとめ
xerj init で Claude Code から使えるようにし、600ファイルほどのフォルダを30秒で検索できる状態にするところまで、つまずかずに進みました。xerj init で書き換わるのがそのフォルダの中だけなのも、試しやすいところです。
ただ、xerj init しただけでは Claude Code は XERJ を使いませんでした。使わせたいなら、頼む時に「xerjを使って」と一言添えるか、前のアプリから機能を移した時のように CLAUDE.md に使い方を1行書いておきます。添えた回は、grep では出てこなかった関連の章まで拾ってきました。日本語だけで検索すると抜粋が空になりやすいので、英単語を混ぜて聞くのが確実です。
前に作ったアプリから機能を移す使い方では、取り込みが10秒ほどで終わり、Claude Code が前のアプリを探してから同じ作りで機能を移し、そのまま動きました。
トークンの節約は、今回の大きさではどちらの使い方でも見えませんでした。grep で数回では見つからないほど大きなフォルダや、全部は読みきれないほど大きな前のプロジェクトから何度も機能を持ってくる人なら、自分のフォルダで比べてみる価値があります。
確認した環境
Claude Code には claude -p(画面を開かずに1回だけ頼む使い方)で頼みました。その際、.mcp.json の XERJ を使ってよいと設定で先に許可し、Claude Code に許可したのはファイルを読むツールと XERJ の検索だけです(機能を移した時は、ファイルを書くツールも許可しました)。機能を移した時は、検証する側の個人設定も読ませていません。